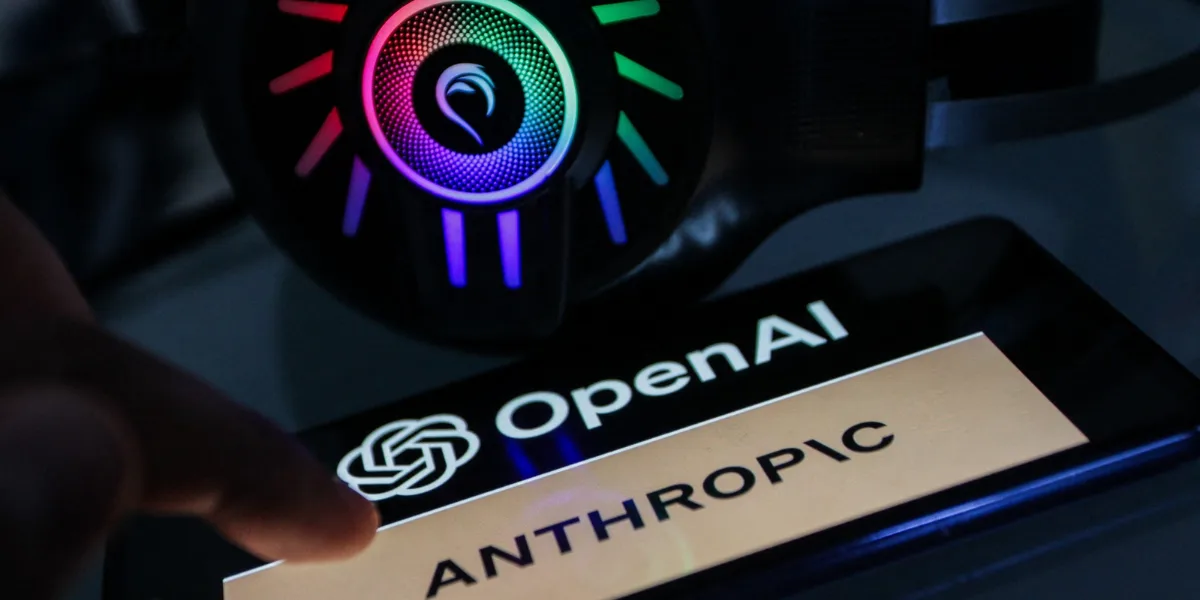
Կիբերանվտանգության հետազոտողները Anthropic-ի ԱԲ-մոդելի միջոցով հաջողությամբ կոտրել են OpenAI-ի ներքին համակարգերը՝ ցույց տալով, թե որքան արագ կարող են ժամանակակից ԱԲ-գործիքները կիրառվել բարդ կիբեռհարձակումների համար, հայտնում է AFP-ն։
Ինչ է տեղի ունենում
Hacktron ընկերության մասնագետները խոցելիություն են հայտնաբերել OpenAI-ի հանրային ֆորումում (որն աշխատում է Discourse հարթակի վրա) և ստացել կայքի լիակատար վերահսկողությունը:
ԱԲ-ի դերը. Հետազոտողները սկզբում օգտագործել են Claude Opus 4.8 մոդելը, սակայն այն չի կարողացել կայուն կերպով իրականացնել հարձակումը:
Բեկումը. Claude Opus 5-ի թողարկումից հետո մոդելն ընդամենը 3 ժամում մշակել է կոտրման լիովին աշխատող տարբերակ:
Ավելի հզոր մոդելներ. Hacktron-ը չի օգտագործել Anthropic-ի Claude Mythos-ը՝ ընկերության ամենահզոր կիբեռմոդելը, որի հասանելիությունը սահմանափակված է միայն ստուգված կազմակերպություններով:
Արձագանքը
Հետազոտողները նախապես տեղեկացրել են OpenAI-ին ու Discourse-ին և համատեղ վերացրել խնդիրը:
OpenAI-ի հաստատումը. Ընկերության ներկայացուցիչ Դրյու Պուսատերին նշել է, որ խոցելիությունը վերացվել է ահազանգ ստանալուց 14 ժամ անց:
Պարգևատրում. OpenAI-ը Hacktron-ին փոխհատուցել է $6,500 պարգևավճար:
Ինչու է սա կարևոր
Այս դեպքը հստակ ցույց է տալիս, թե ինչպես է արհեստական բանականության զարգացումը փոխում կիբեռանվտանգության լանդշաֆտը.
1. Ծախսերի և ժամանակի կրճատում. ԱԲ-ն էապես կրճատում է բարդ կիբեռհարձակումների ժամանակն ու ծախսերը, որոնք նախկինում պահանջում էին մասնագիտացված թիմեր և երկարատև նախապատրաստություն:
2. Լայն տարածում. Հետազոտողների փոխանցմամբ՝ նմանատիպ թերություններ առկա են նաև Slack-ի և Meta-յի ապրանքատեսակներում:
Հաջորդ քայլը
Hacktron-ը հայտարարել է, որ շարունակելու է այլ խոշոր կազմակերպությունների համակարգերի նմանօրինակ ստուգումները՝ նոր խոցելիություններ հայտնաբերելու և դրանք կանխարգելելու համար: